开源社区出现了一个新的推理方案:Strata 引擎把 1250 亿参数级别的模型放进了 12GB 显存的消费级显卡里运行。该方案由开发者 Niko1221 开源,所加载的模型是阿里 Qwen 团队的 Qwen3.8-Flash-Next——一个 125B 参数的多模态 MoE 压缩版本,原生支持 262K token 上下文。
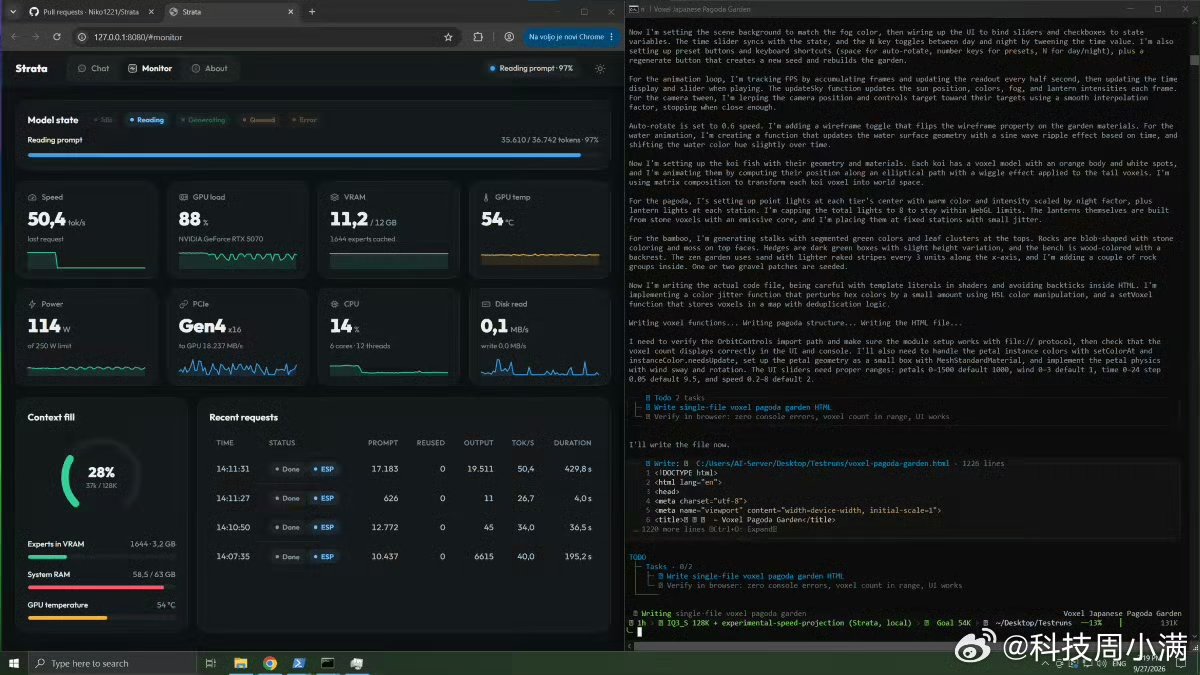
其技术路线由三部分组成:MoE 模型主体驻留在内存中,被频繁调用的专家层放进显存,再借助一个轻量模型完成投机解码。
实测数据方面,RTX 5070 运行 2 比特量化版本时,输出速度为每秒 94 词元;RX 9070 XT 同样可以达到每秒 60 词元。
这套方案把硬件门槛拉到了消费级:此前需要上万元级别的显卡才能运行的工作负载,如今单张 5070 即可承担。
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。