12GB 显存跑通 262K 上下文:MiMo-V2.6-Distill-Qwen-9B 本地部署方案
一张 12GB 显存的 RTX 3060,就能把 262K 超长上下文的推理跑起来。这套低成本本地部署方案针对的是 MiMo-V2.6-Distill-Qwen-9B,硬件门槛压在单张消费级显卡上。
量化与推理配置
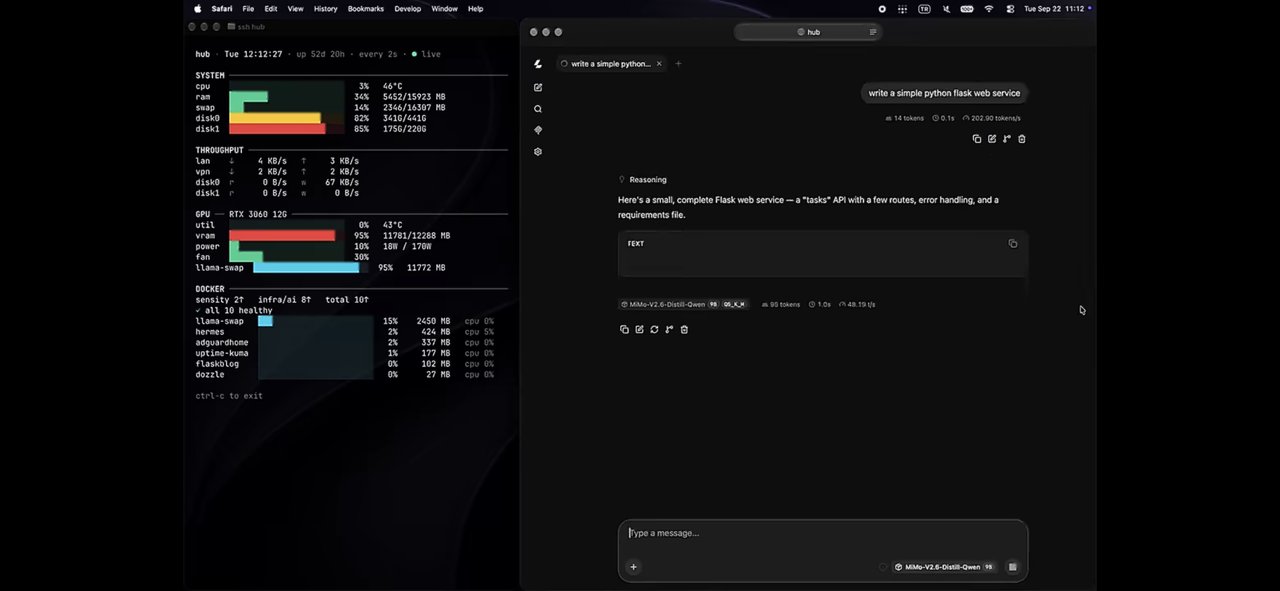
方案采用 Q5_K_M 量化,同时开启 Q8 KV 缓存,并启用 Flash Attention。三者配合,让 9B 级模型在 12GB 显存内装下超长上下文。
实测性能
- 解码速度:约 47 tok/s
- 预填充速度:约 1600 tok/s
模型来源与能力
MiMo-V2.6-Distill-Qwen-9B 由 Qwen3.5-9B 蒸馏而来,通过吸收教师大模型的推理能力获得提升。在 SWE-Pro 上,其得分从 32.0 提高到 44.6。
意义
长上下文编码 Agent 不再依赖多卡堆砌,也不需要动用 70B 级别的模型,单卡即可承载。
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。