MiniMax H3 的能力和热度都摆在那里,在 AI 视频领域,开源模型还能打到这个水平,目前也就它一家。
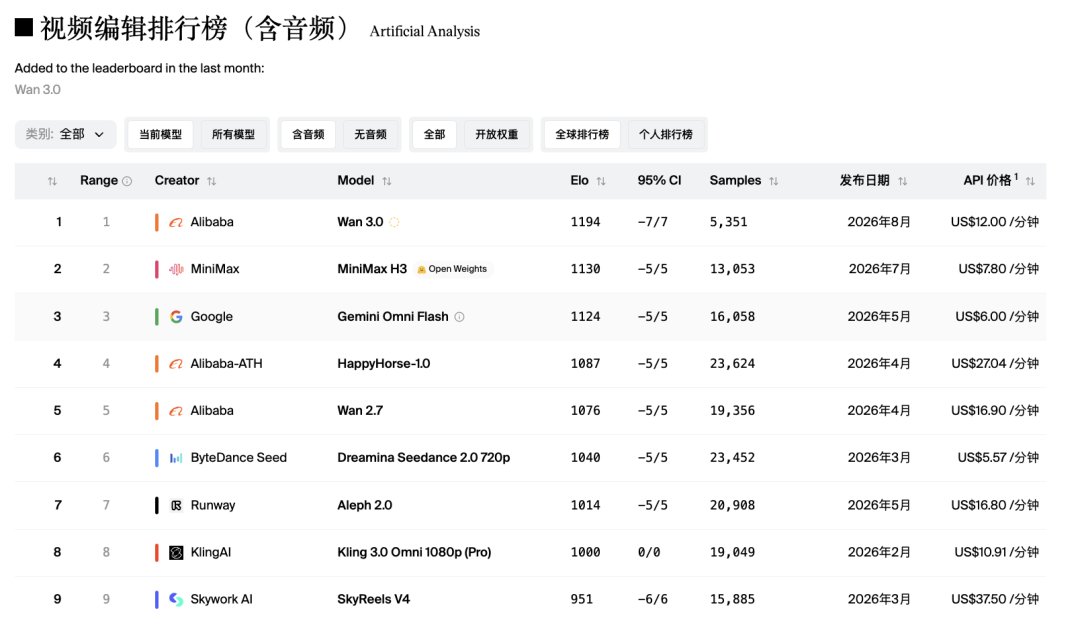
底座足够强,开发者就坐不住,开始琢磨怎么把它用得更顺。H3 开源的消息刚落地,各种工作流、ComfyUI 节点和垂直方向的优化方案就陆续出现了。
一站式 AIGC 创作平台 RunningHub 挑中的,是大家最着急的那件事:让 H3 跑得更快。
道理很直白——模型越好用,人就越想多抽几次,可每一次都要等。创意改一版只要十几秒,脑子里下一版都剪完了,屏幕上那一版还在转。
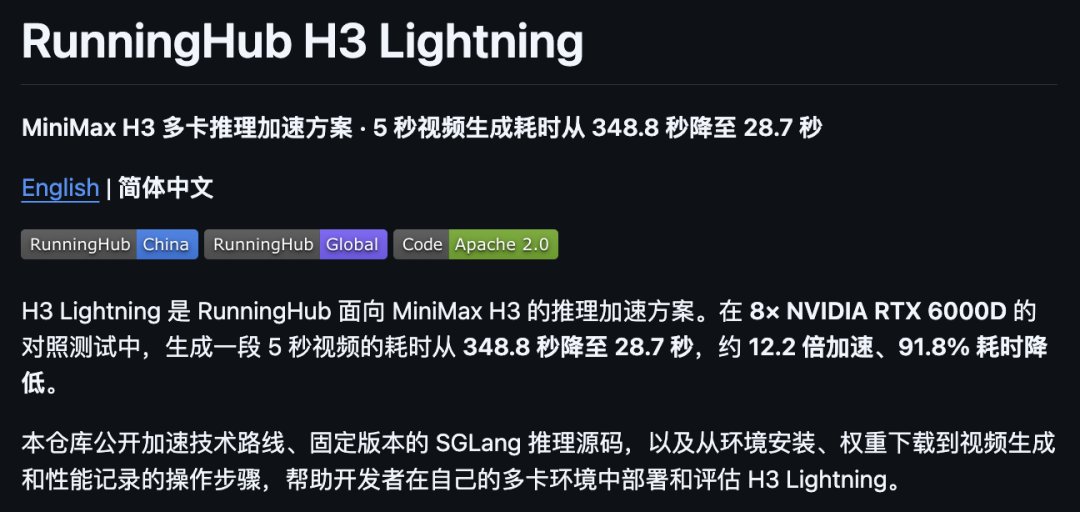
RunningHub 的做法是给 H3 踩一脚油门,把等待时间直接切掉一块。
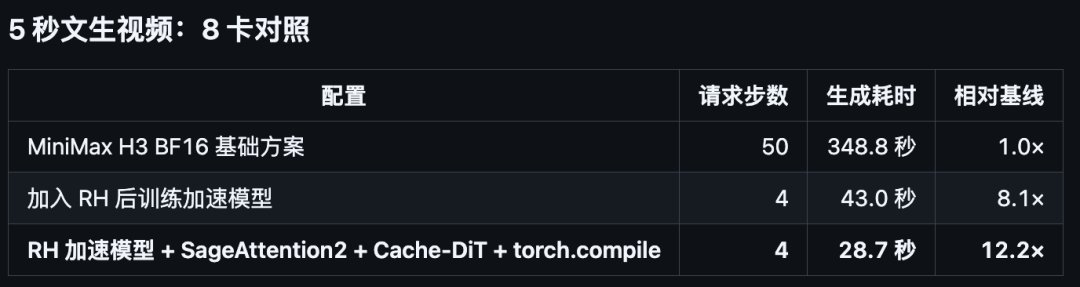
同样是生成 5 秒、1344×768 的视频,在 4 张 RTX 6000D 上,原始 BF16 的 50 步方案要花 348.8 秒,接近 6 分钟;换成 RunningHub H3 Lightning 完整加速之后,只需 28.7 秒。
前后大约 12 倍提速,生成耗时下降约 92%,BF16 数值精度依然保留。
目前这套方案已经在 GitHub 上开源,任何创作者都能直接拿来用:
(https://github.com/RH-RunningHub/MiniMax-H3-MultiGPU-Lightning/)
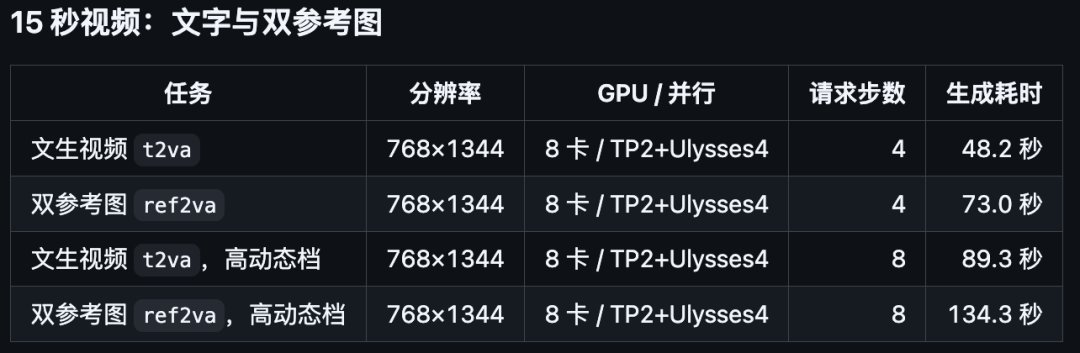
5 秒视频之外,15 秒、双参考图这类更重的任务,H3 Lightning 一样能加速。
在 8 张 RTX 6000D 的环境下,让 H3 生成一条 15 秒、768×1344 的视频,纯文字生成约 48 秒,双参考图生成约 73 秒。也就是说,一条 15 秒的图生视频已经能压进「1 分钟出结果」这个尺度。
而且在这套方案里,加速并不等于画质打折:全程保持 BF16 满血精度,没有走降精度换速度的路子。
一个本来就够能打的模型又被优化了一轮,自然要亲手试一下。
先试了 5 秒、768P 的文生视频,选了个动作幅度大的场景。
沙漠里,一名女越野摩托车手原地起步,接着高速冲上沙丘,腾空、落地,再补一个大幅甩尾。
光这样还不够,镜头也加了变化:先用低机位侧面追车,再绕到正面倒退跟拍,最后让摩托从镜头旁边冲过去。
从点击生成到出片,实际用时约 30 秒,人、车、沙尘的运动逻辑比较连贯。
落地时车身有明显下沉和回弹,骑手的重心同步下压,扬起的尘土看着也真实。预设的机位也都按设想完成了。
除了画质,最直接的感受是:等待的间隙连一个短视频都没刷完。
确实顺滑。
不过 5 秒还是短,得加点强度。
接着试 15 秒的图生视频,这次喂进去一张吉卜力风格的参考图。
原本是一人一狗背对镜头坐在草地上,现在让他俩跑起来:少年从草地起身,直接朝山坡前方奔跑;金毛也跟着起来,边跑边跳;少年中途张开双臂、转身继续跑。
镜头从背后推进,切到侧面跟拍,最后拉远,把整个山谷重新带进画面。
15 秒长视频的生成时间要久一些,从点击到出片大约 88 秒。
从坐着到起身,再到迈步加速,动作之间的衔接比较清楚;金毛也没有变成跟着人物平移的贴纸,自己完成了起身、奔跑和跳跃。
更关键的是,15 秒跑下来,这一人一狗基本还是原来那一人一狗。少年的黄色外套、蓝色裤子、黑色头发这些主要特征始终在,金毛的体型和毛色也没有跑到后半段突然换了品种。镜头转完一圈,远处的湖泊和夕阳也还留在画面里。
当然,盯着细看还是能挑出问题:狗快速跳跃时,四肢动作偶尔会有点「硬」,不过不至于出戏。
本来打算收工,又冒出一个念头:晴天不要了,改成下雨。
创作的灵感就是这么跳。
少年要站起来撑伞,在草地上跑,再突然停下转一圈;金毛继续绕着他跑,还要从旁边跳过去。与此同时,原来的远山和湖泊得留住。
二次创作的时间更短,大约 50 秒,最后画面远处还出现了一抹彩虹。
以前想改人物、场景、镜头,动手前总要先掂量一下值不值得再等那么久。现在有灵感就能快速出片,创意落地和试错的时间成本都降了下来,也不必再因为漫长等待砍掉那些一闪而过的想法。
那么问题来了:不降 BF16 精度,也不靠顶级数据中心算力,RunningHub 抠出来的时间来自哪里?
答案是用工程抠出来的,解法是很工整的三刀——先看哪里算得太多,再看哪里算得太慢,最后看几张 GPU 之间有没有时间浪费在互相等待上。
第一刀:让模型少算一点
视频生成不是模型读完 Prompt 就啪一下把最终画面吐出来,它需要一轮一轮地把画面「想」出来。
把文字或图片变成视频要经过多轮计算,画面才会逐渐从噪声中成形,这个轮次叫生成步数。原始 H3 推理默认 50 步,每一步背后都是一轮实打实的计算,步数越多,GPU 干得越久。
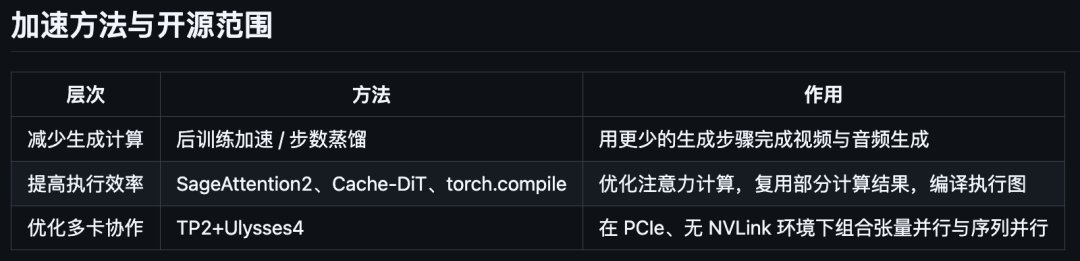
RunningHub 做的第一件事,是引入自研的 RH 后训练加速模型:让 H3 经过后训练之后,学会用更少的步数把视频做出来,同时不丢画质。
效果相当明显。同样用 4 张 RTX 6000D 生成 5 秒视频,换成 RH 后训练加速模型的 9 步测试方案,时间直接缩到 43 秒。
第一刀下去,已经提速 8 倍。
顺带说一句,RunningHub 的推荐配置是默认 4 步;遇到快速运动、大幅动作这类难任务可以切到 8 步,快还是稳,由创作者自己定。
第二刀:把必须算的部分算得更高效
做到 43 秒,按理说已经够猛,但 RunningHub 显然还嫌慢。模型虽然少算了,剩下那些必须完成的计算总不能放着不管:还有没有地方能继续省时间?
于是第二刀砍向执行层,一口气上了三个技术组合:SageAttention2、Cache-DiT 和 torch.compile。
SageAttention2 盯的是注意力计算。视频模型每生成一段内容,都要处理大量画面元素之间的关系——谁和谁相关、前后画面怎么联系、不同信息怎么共同影响最终结果,这些注意力计算本身就是推理过程中相当吃算力的一环。SageAttention2 要做的,就是让这块核心计算执行得更高效。
Cache-DiT 盯的是重复劳动。视频生成前后多个计算步骤之间存在可以复用的信息,有些中间结果既然已经算过,后面的步骤就不必每次都从头再来。能缓存的缓存,能复用的复用,重复工作减下来,时间还能继续往下挤。
最后是 torch.compile,它对计算过程做编译优化,让 GPU 执行这些操作时更顺畅,减少原本零散的调度和执行开销。
当 RH 后训练加速模型与这些算子、缓存、编译优化叠到一起,该跑快的跑快,该复用的复用,该捋顺的捋顺,刚才压到 43 秒的生成过程又被压到 28.7 秒。
第三刀:多卡之间别互相等
但这还没完。H3 这种视频模型真跑起来,往往不会只靠一张 GPU 单打独斗;多张卡一起干活,新问题就来了。
卡多,不等于一定快,这和多人一起干活很像。八个人当然比一个人手多,可如果任务分配不合适,每个人刚干两下就要停下来等别人递东西,A 等 B、B 等 C,时间全耗在互相交接上。
多卡推理是同样的道理。GPU 之间需要不断交换数据,而在没有 NVLink 高速互联、主要依靠 PCIe 通信的环境里,卡间通信的成本尤其不能忽略。
RunningHub 专门针对这种环境,把不同的多卡并行方式重新测了一遍,最后选中的组合是 TP2+Ulysses4:TP 负责从张量计算层面拆任务,Ulysses 则进一步从序列维度做并行。
在 8 张 RTX 6000D、PCIe 连接且没有 NVLink 的环境下,TP2+Ulysses4 相比 TP4+Ulysses2,速度快约 12%,同时减少约 14GiB 显存占用。
整体技术路径基本就是沿着推理链路一路抠时间:RH 后训练加速模型先把需要完成的计算量压下来;SageAttention2、Cache-DiT 和 torch.compile 继续提高剩余计算的执行效率;到了多卡层面,再用 TP2+Ulysses4 减少通信和资源上的浪费。最后,RunningHub 把这些方法全部整合进 SGLang multimodal_gen 推理引擎,由它把模型生成、多卡协同和各种加速组件真正组织到一起。
手里的机器能不能跑出这个速度
现在 AI 行业的性能数字已经卷得飞起,只要舍得堆顶级 GPU、高速互联和数据中心,把模型跑得飞快并不稀奇。可真正想本地部署开源视频模型的创作者、工作室和中小团队要问的是:我手里的机器,能不能跑出这个速度?
RunningHub 的回答是:必须能。
H3 Lightning 特意绕开了「超能力解法」,针对的就是无 NVLink 的 PCIe 多卡环境,RTX 6000D 也是公开可购买的专业 GPU 规格。换句话说,RunningHub 从一开始针对性优化的,就是一种更贴近工作室和企业团队实际部署的多卡环境。
当然,如果预算没有上限,用 B300 的卡配合这套方式,出片速度能直接提升到秒级。
从环境安装、模型下载到服务启动和推理测试,H3 Lightning 的整个本地部署流程都已公开。开发者也可以结合公开的社区加速 LoRA,再配上前面提到的注意力优化、计算缓存和多卡并行,在自己的机器上重新跑一遍;到底要几张卡、怎么调参数、速度和画质怎么取舍,都可以围绕自己的业务适配。
有设备的团队可以照着开源方案自己部署;没有多卡服务器、不想研究环境配置的创作者,直接在 RunningHub 上点开 H3 Lightning 也能用。
围绕开源模型的两条路
一个足够强的开源模型出来之后,围绕它会出现很多「二创」。
有人会拿开源底座继续做后训练,把优化后的能力跑在顶级数据中心集群上,再封装成 API 提供给用户。用户不需要关心背后的 GPU 和工程优化,按调用付费就能拿到结果,这当然是一种很成熟的商业路径。
另一边,也会有人选择把优化继续留在开源生态里——开发者自己拥有硬件、自己部署模型,围绕自己的工作流继续改,优化方法又能被下一批开发者拿去复现和迭代。
RunningHub 这次明显更偏向后者。而且,这已经不是它第一次围着 H3 这么干了。
H3 刚开源时,RunningHub 首先做的是接入:模型一出来,平台第一时间把它接进来,让创作者不用先研究一大堆部署问题,就能上手尝试新模型。
随后它又参与生态共建,把全套 ComfyUI 节点开源。开发者能玩的就更多了:有人拿 H3 做电商内容,有人做短剧、漫剧,有人研究声音克隆、动作克隆和音频驱动,还有人继续把自己的玩法封装成新的工作流。
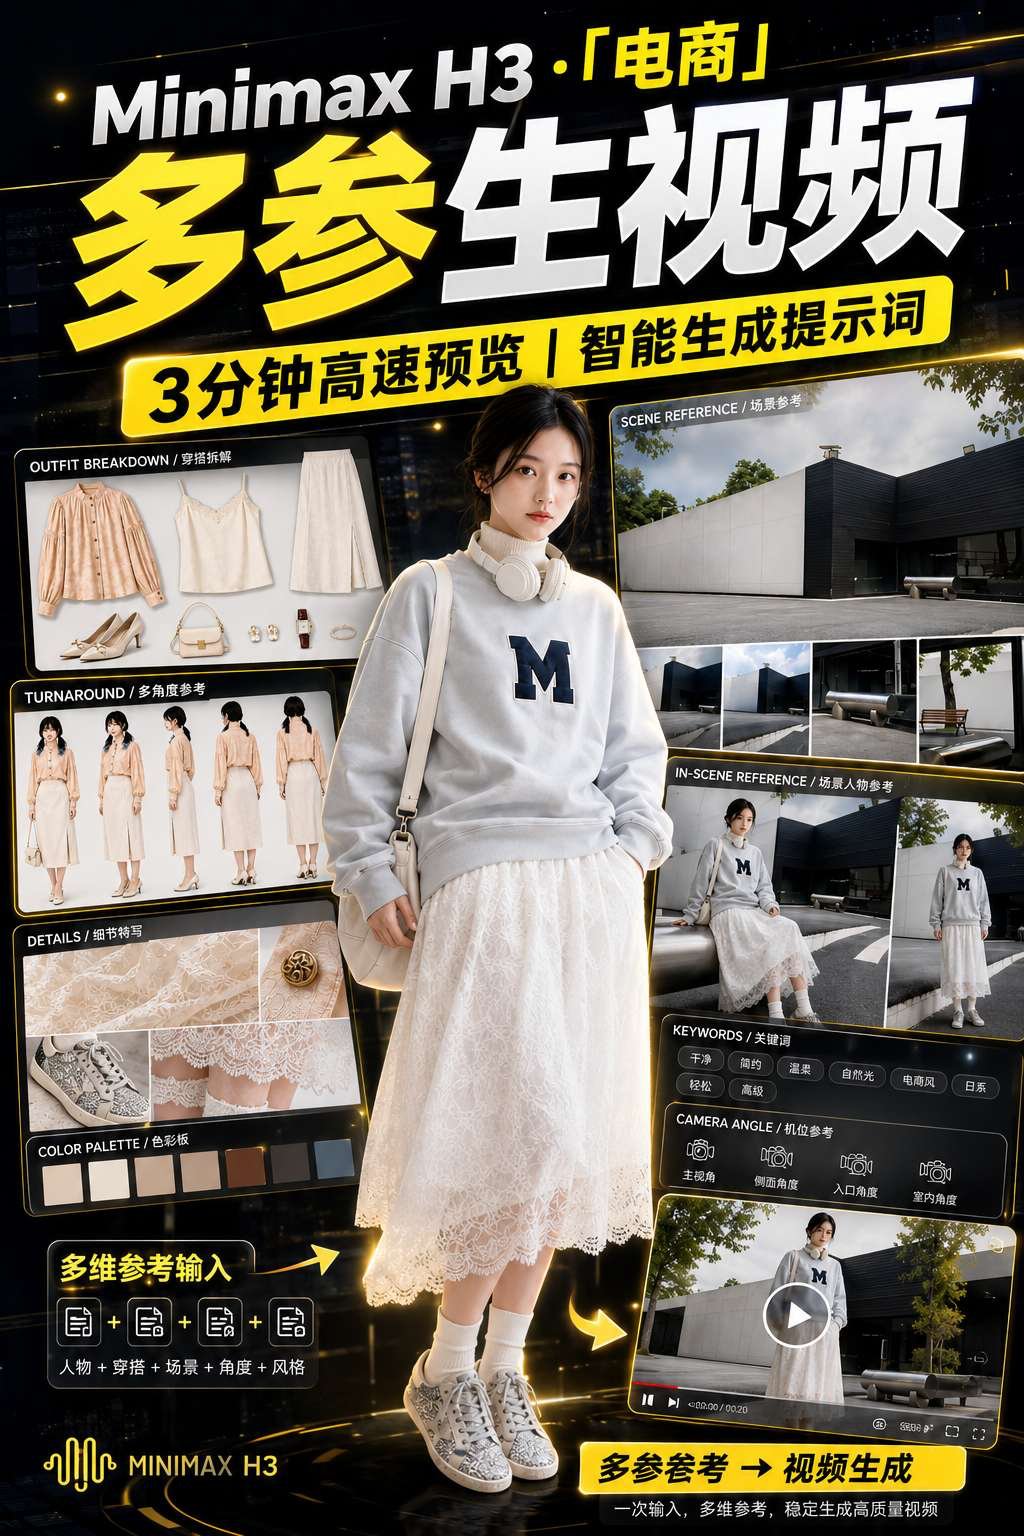
比如创作者 @魅力创意 直接盯上了电商视频。TA 发布的 MiniMax H3·电商多参生视频工作流,只需要把商品、模特、场景一股脑塞进去,再简单说说卖点,H3 就能自己琢磨人物该在哪儿、商品怎么露出、场景怎么搭,最后直接给出一条完整的电商广告。
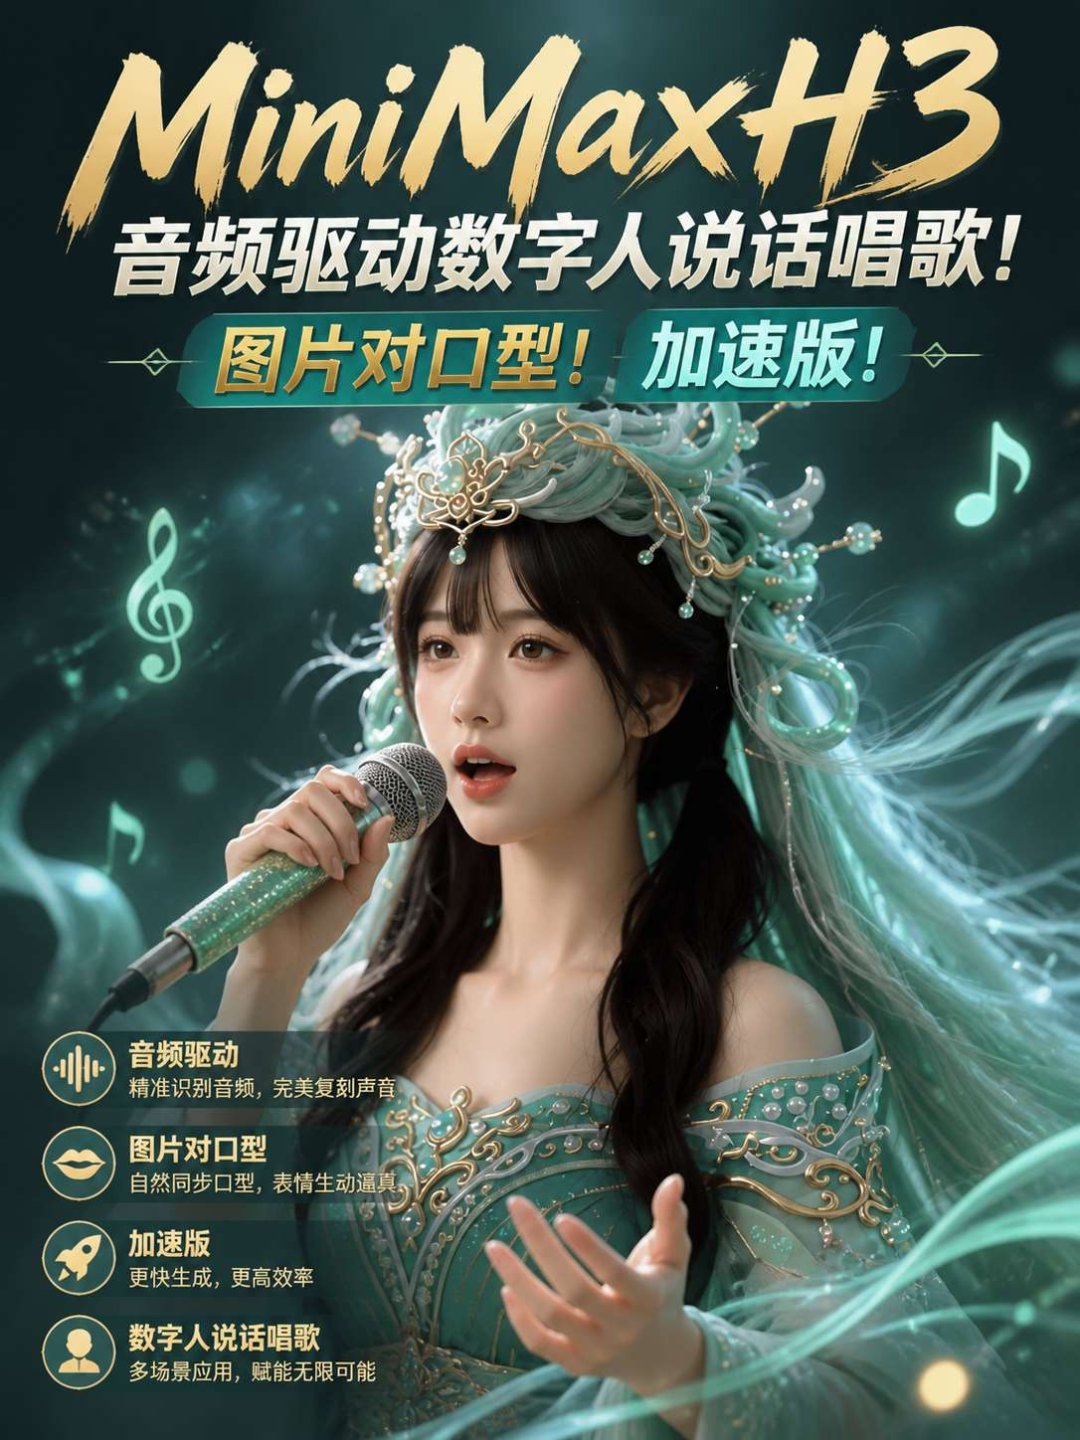
还有创作者 @艾橘溪 做的音频驱动数字人说话唱歌工作流:上传一张人物图片,再扔进去一段音频,原本静止的人物就能变成数字人开口营业,不管说话还是唱歌,口型和节奏都能同步对上。
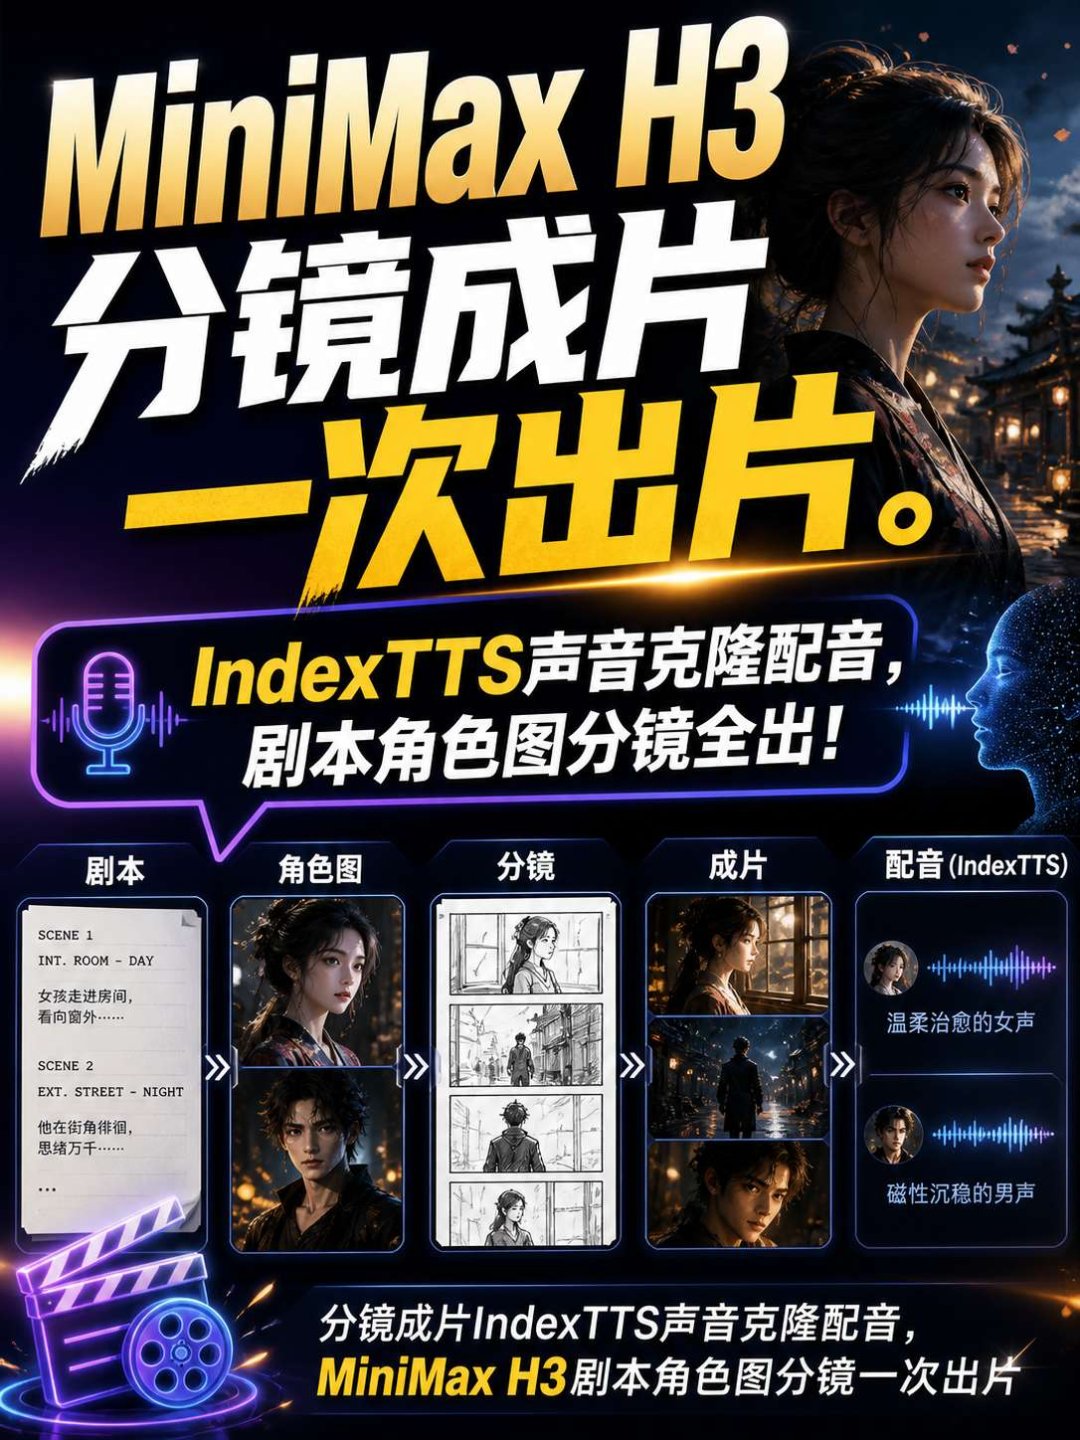
今年很火的漫剧,创作者 @qwlulnpi 也搬出了新创意:把分镜图、脚本、音频一次性丢进去,就能拿到有画面有声音的完整成片,多少有点「素材备齐,一把梭哈」的流水线味道。
这还只是 RunningHub 上冒出来的一小撮玩法。自打 H3 上线以来,RunningHub 平台上已经有上千名创作者,围绕它开源了近万条创意工作流。
这也是开源模型的乐趣所在:一个人解决一点问题,最后整个生态能用的东西就越来越多。而 H3 Lightning 相当于 RunningHub 再进一步,开始把自己积累的工程能力反过来贡献给 H3,直接解决推理效率的问题。
从海马云看这次加速
如果只看 RunningHub,一个 AIGC 创作平台突然跑去研究后训练、算子优化和多卡并行,多少有点跨界。但把它放回母公司海马云过去十多年的技术演进里,这件事其实顺理成章。
海马云 2014 年成立,过去十多年长期和 GPU、高性能内容打交道。那个时候,行业面对的问题还不是「AI 大模型怎么推理」,核心矛盾是游戏、图形、高性能数字内容体量越来越大,如何让这些负载稳定、高速地运行起来。GPU 容器调度、图形虚拟化、实时流媒体、大规模云渲染,海马云的整套能力体系都是围绕这个目标打磨的。
时至今日,海马云已经在国内建设 60 余个边缘节点,支撑超过 2000 万月活用户的智算服务。
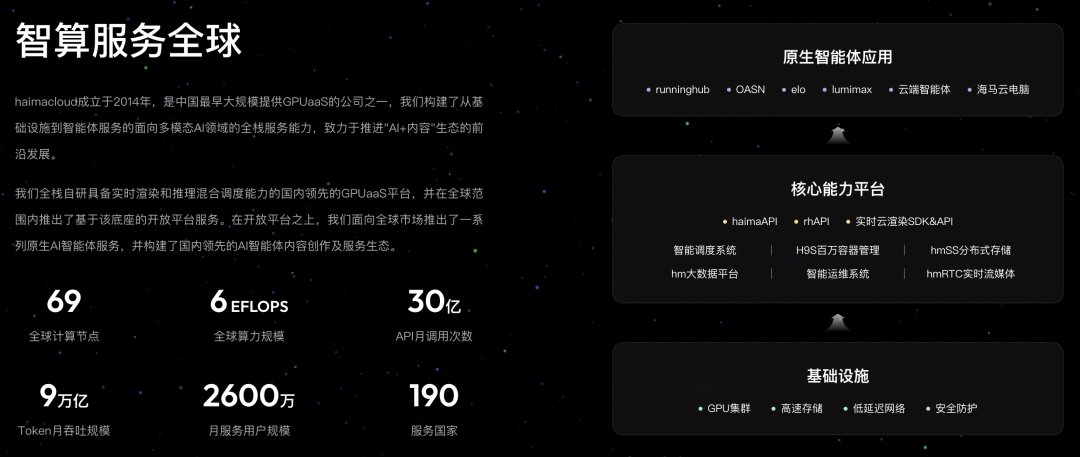
到了生成式 AI 时代,需要被高效调度的计算对象变了:除了游戏、图形和高性能数字内容,现在还加入了大模型以及模型驱动的内容生成。海马云面对的命题也随之从「高性能内容怎么跑」,转向「AI 能力如何调用,又如何高效落地」。
计算对象从云渲染变成 AI 推理,却恰好让海马云这家原生 AI 公司十余年的技术积累有了更大的发挥场景。所以 RunningHub 并不算「跨界」做模型加速——H3 Lightning 是海马云「GPU 工程能力」在 AI 时代的一个新落点,补齐的也是开源模型从权重到生产力之间缺失的环节。
过去一年,开源模型越来越多,真正稀缺的是:谁能在模型开源之后,最快把它接进真实环境、优化到生产可用,再把这些能力持续回馈给社区。
模型开源,RunningHub 平台完成接入,创作者「能直接用」了;开放 ComfyUI 节点与工作流,创作者「能玩的花样」多了;而 H3 Lightning 推理优化,则是在模型跑通之后继续攻克速度、成本与硬件门槛,把单次试玩的内容生成升级为可稳定复用的批量生产力。
RunningHub 就是这样一个生态反哺者。
GitHub 仓库:https://github.com/RH-RunningHub/MiniMax-H3-MultiGPU-Lightning/
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。