本地视频生成长期受制于算力,这一局面正在被改写。
MiniMax-H3 开源之后,凭借原生音视频同步、24fps 影视级运动幅度,加上首尾帧控制(FL2VA)与多模态参考(Ref2VA),很快站到了开源视频生成的第一梯队。但它原生推理要跑数十步迭代,显存开销也极大,只配了消费级显卡的本地创作者基本被挡在门外:要么转去租云端算力,要么在本地看着显存被吃满、程序报错。
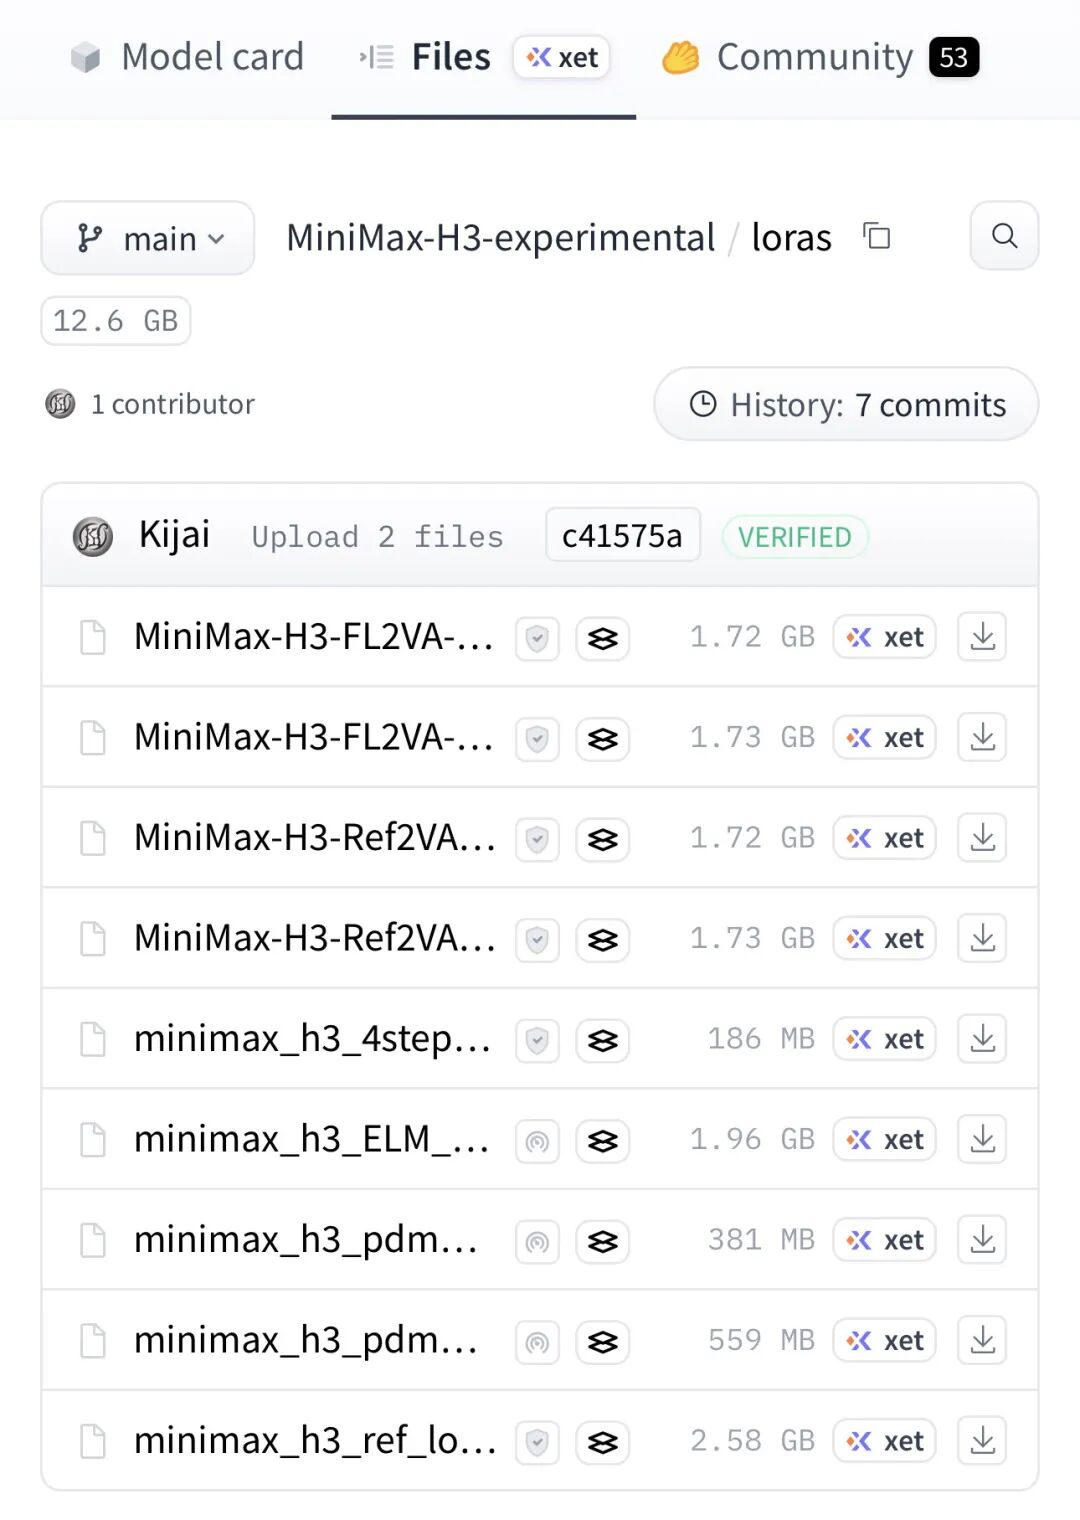
转机来自 ComfyUI 生态的核心开发者 Kijai。他在 Hugging Face 仓库(Kijai/MiniMax-H3-experimental/loras)放出了一组专为 MiniMax-H3 做的 PDMD 加速 LoRA,几个关键点很直接:
- 模型体积极小:2-Step 只有 381 MB,4-Step 为 559 MB;
- 步数压到极限:从数十步直接降到 2 步或 4 步;
- 消费级显卡解禁:12GB 显存的卡不必再当旁观者,普通个人工作站也能跑高品质本地视频渲染。
这次更新不只是把权重裁小,而是在计算路径与显存占用两头同时下手的模型蒸馏成果:
Kijai / MiniMax-H3-experimental / loras
├── minimax_h3_pdmd_2step_lora_avg_rank_38_bf16.safetensors (381 MB)
└── minimax_h3_pdmd_4step_lora_avg_rank_57_bf16.safetensors (559 MB)
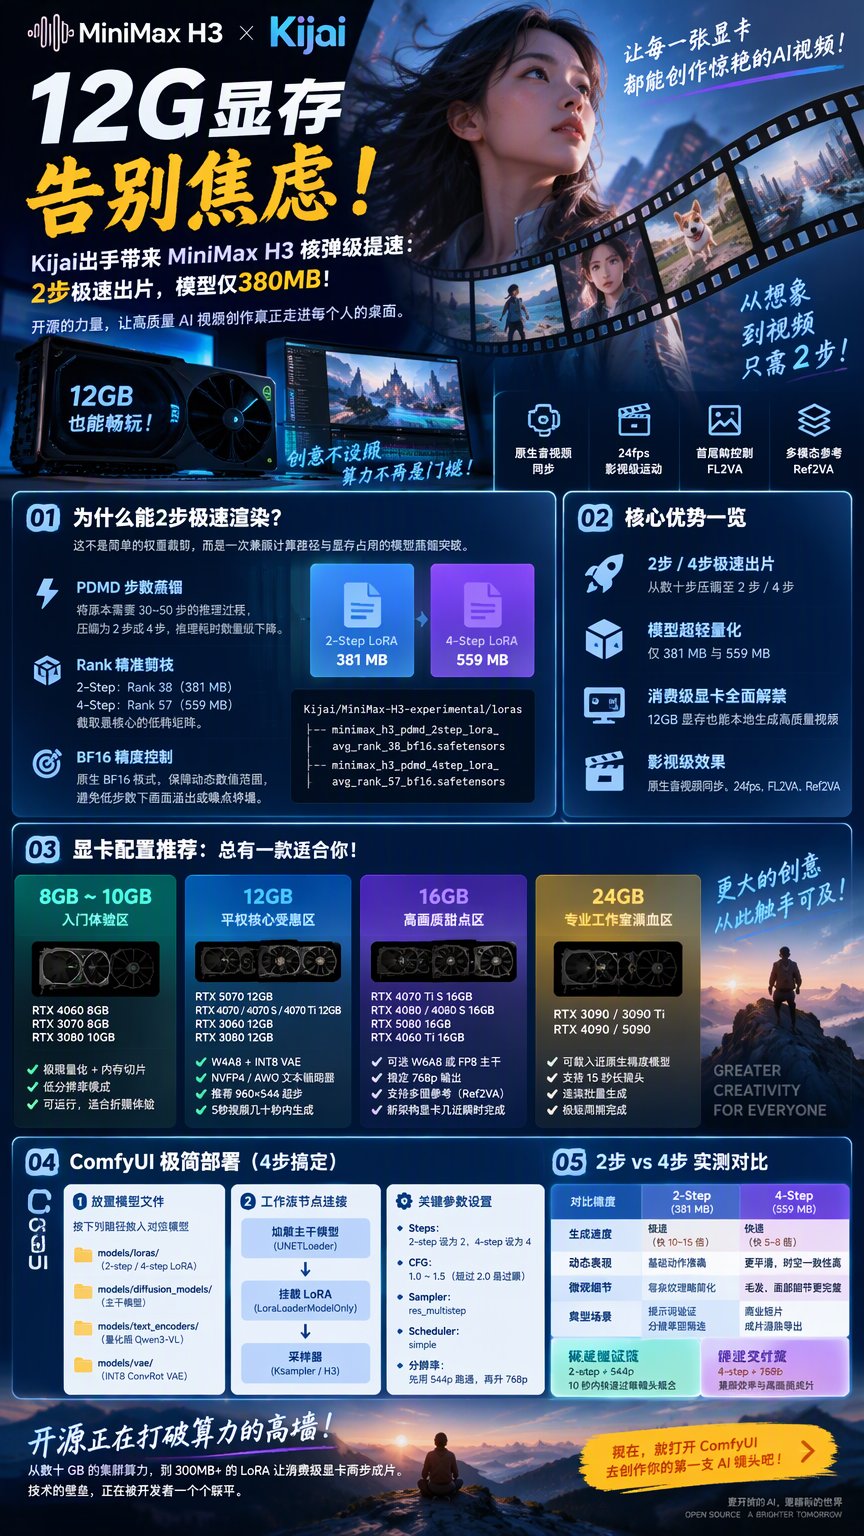
PDMD(Progressive Distillation / Multi-step Diffusion Distillation)采用渐进式轨迹蒸馏算法,把扩散模型在潜空间里的去噪演变路径重新组织了一遍。原先要反复校正 30~50 次的数值积分,被它拟合成 2 次或 4 次高度浓缩的大步长跃迁,推理耗时因此下降了一个数量级。
- 2-Step 版本:走 Rank 38 的轻量路线,文件 381 MB,主要抽取主干网络中运动趋势与全局结构最关键的低秩矩阵;
- 4-Step 版本:Rank 提到 57,体积 559 MB,在把推理周期大幅压缩的同时,保留了更完整的高频几何边缘与纹理细节。
两个版本都用原生 BF16 格式,保证运算中的动态数值范围,避免低步数下出现明显画面溢出或噪点坍塌。
再配合 Kijai 仓库里的套件组合,比如 W4A8/W6A8 量化主干、INT8 ConvRot 视频 VAE、Qwen3-VL 文本编码器量化版,MiniMax-H3 的显存门槛被整体拉低。以下是目前主流消费级显卡的实测配置梯队与运行策略。
12GB 显存档
代表显卡:RTX 5070 12GB、RTX 4070 / 4070 Super / 4070 Ti 12GB、RTX 3060 12GB、RTX 3080 12GB
运行策略:
- 主干组合:W4A8 Mixed 剪枝主模型 + INT8 ConvRot 轻量 VAE;
- 文本编码器:选 NVFP4 / AWQ 量化版本;
- 输出规格:初始分辨率建议 960×544(5 秒视频预览),进阶再测 1344×768(768p);
- 实际表现:有 2-Step / 4-Step LoRA 加持,12GB 显存全程不溢出,单段 5 秒视频的生成时间从数分钟级压到几十秒内,RTX 3060 12GB 这类老卡用户也能顺畅跑。
16GB 显存档
代表显卡:RTX 4070 Ti Super 16GB、RTX 4080 / 4080 Super 16GB、RTX 5080 16GB、RTX 4060 Ti 16GB
- 主干组合:可以选精度更高的 W6A8 或 FP8 主干模型,搭配 4-Step LoRA;
- 输出规格:768p 原生点对点画质输出可以稳定承载,显存更富余时还能开启多图参考(Ref2VA)通道;
- 实际表现:吞吐很快,在新架构显卡(如 5080/4080)上,4 步推理几乎瞬时完成。
24GB 及以上档
代表显卡:RTX 3090 / RTX 3090 Ti / RTX 4090 / RTX 5090
- 主干组合:不必做激进的模型切片,可尝试载入接近原生精度的 Transformer,再配 2-step 或 4-step LoRA,把单帧出片速度压到极限;
- 输出规格:满血 15 秒长镜头渲染或连续批量抽卡都支持,生成耗时缩到极短周期。
8~10GB 显存档
代表显卡:RTX 4060 8GB、RTX 3070 / 3070 Ti 8GB、RTX 3080 10GB
- 主干组合:必须打开 ComfyUI 的 CPU/GPU 极端内存切片调度(Offload),同时搭配极限量化 GGUF / W4A8 与低分辨率模式;
- 体验建议:虽然有系统内存交换的开销,但在 2 步去噪的加持下,推理总时间仍在可接受范围内。
部署步骤
先把 ComfyUI 更新到最新版(建议 0.31.0 以上,以保证对 W4A8 与 INT8 ConvRot 的算子支持完整):
- LoRA 路径:在 ComfyUI/models/loras/ 放入
- Diffusion Model 路径:在 ComfyUI/models/diffusion_models/ 放入对应主干模型(如 minimax_h3_fl2va_pruned_w4a8_mixed.safetensors)
- Text Encoder 路径:在 ComfyUI/models/text_encoders/ 放入量化版文本编码器(如 qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors)
- VAE 路径:在 ComfyUI/models/vae/ 放入 minimax_h3_video_vae_int8_convrot.safetensors
节点连接:
- 加载主干模型:用 UNETLoader(或专用 H3 Loader)载入量化主模型;
- 挂载加速 LoRA:后接 LoraLoaderModelOnly 节点,载入对应 PDMD LoRA,强度建议 0.8 ~ 1.0;
- 采样器连接:把处理后的 Model 输出接到 KSampler 或 H3 专用采样通道。
参数要点
- Steps(步数):不能随意设。挂 2-step LoRA 时步数必须是 2;挂 4-step LoRA 时必须设成 4;
- CFG(引导尺度):一定要压低。蒸馏模型对高 CFG 极为敏感,建议 1.0 ~ 1.5,超过 2.0 容易出现画面过曝或纹理烧焦;
- Sampler / Scheduler 搭配:推荐官方兼容的 res_multistep 采样器加 simple 调度策略;
- 分辨率梯度渐进:第一次测试先用 544p 把链路跑通,确认不报错再升到 768p 生成正片。
两个版本怎么选
| 对比维度 | 2-Step LoRA (381 MB) | 4-Step LoRA (559 MB) |
|---|---|---|
| 生成速度 | 极速,相较基模加速约 10~15 倍 | 快速,相较基模加速约 5~8 倍 |
| 动态表现 | 镜头推拉、基础肢体动作准确到位 | 连续运动更平滑,时空一致性更高 |
| 微观细节 | 复杂背景纹理略有简化 | 毛发、面部微表情、光影层次完整度高 |
| 典型适用场景 | 快速验证提示词、分镜草图筛选、批量构图 | 商业短片分镜正片、成片渲染导出 |
对应到实际工作流,可以分成两条:
- 极速验证流:用 2-step 配 544p 分辨率,10 秒内快速过审镜头概念;
- 终选交付流:锁定满意的种子(Seed)与动作后,切到 4-step、768p 生成成片,必要时串联轻度放大工作流,兼顾效率与画质。
从过去动辄要数十 GB 显存的集群算力,到现在 300MB+ 级别的 LoRA 让消费级显卡两步成片,开源社区又一次说明了工程优化与算法蒸馏的分量。技术壁垒被开发者不断踩平,算力焦虑也在一次次代码提交中被化解。显卡已经就绪,打开 ComfyUI,就可以开始做自己的第一支极速 AI 镜头。
欢迎在评论区分享 Kijai 这个版本的测试体验。
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。