Anthropic 刚刚推出 Claude Opus 5.5,这是 Claude 5.5 系列打头阵的模型,Sonnet 5.5 与 Haiku 5.5 会在接下来几周内跟上。官方给出的说法是:它在多数任务上已经站到 Claude Fable 5.1 的高度,典型任务成本比 Opus 5 少 40%,输出速度则快了 30% 以上。它的定位是长时间编程 Agent 与知识工作的主力机型。
榜单:有领先,也有落后
官方成绩显示,Opus 5.5 在 Agent 编程、电脑操作和专业工作上都有明显抬升。
- Terminal-Bench 4.0:66.4%,高于 GPT-6 Astra 的 57.9% 与 Opus 5 的 52.3%
- FrontierCode v1.1:54.4%,略高于 GPT-6 Astra 的 53.3%
- CursorBench 4.0:从 Opus 5 的 46.6% 升到 57.8%
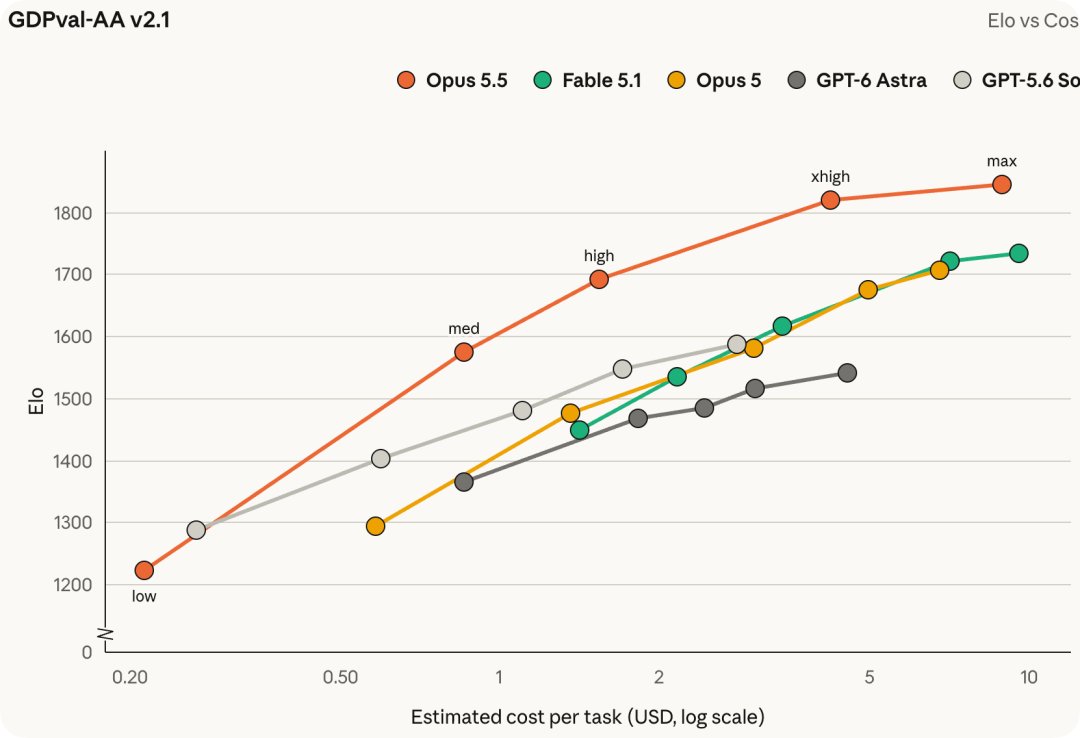
- GDPval-AA v2.1(知识工作):1846 Elo,超过 Fable 5.1 的 1735 和 Opus 5 的 1708
- OSWorld 2.0(电脑操作):从 Opus 5 的 74.0% 升到 81.8%
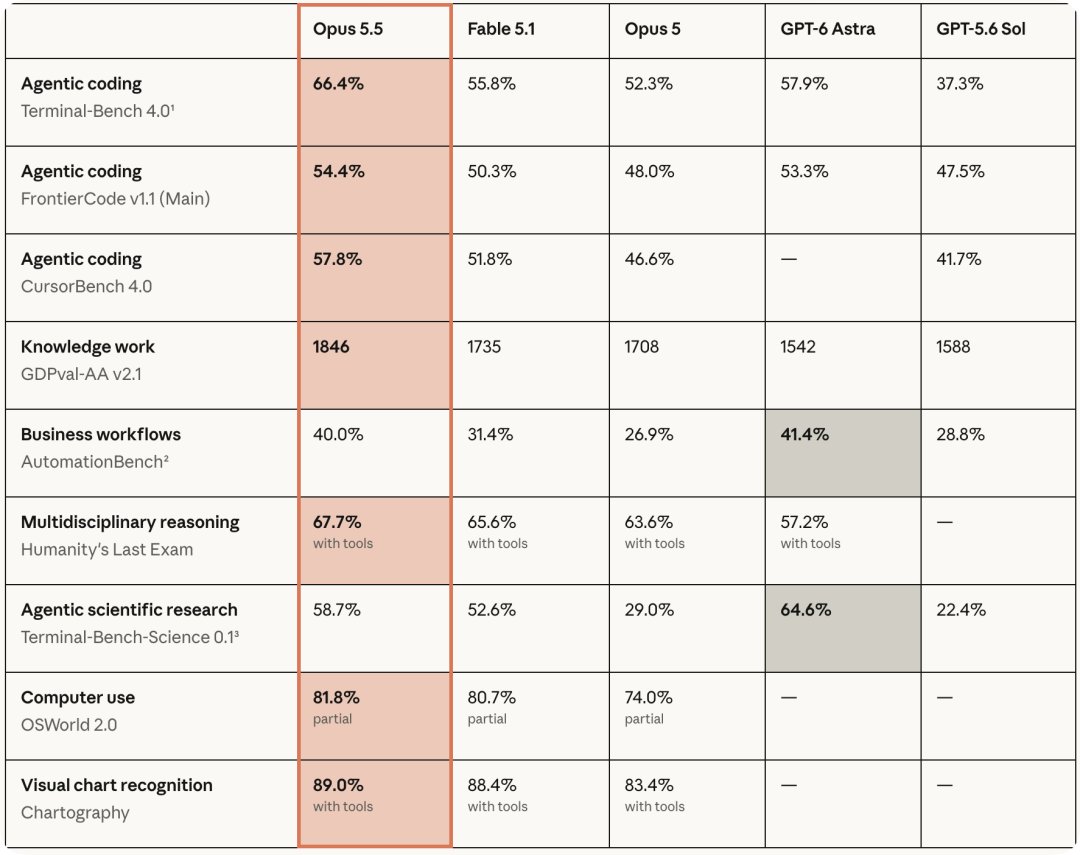
并非每一项都占优。AutomationBench 上它拿到 40.0%,比 GPT-6 Astra 的 41.4% 略低;Terminal-Bench-Science 0.1 为 58.7%,与 Astra 的 64.6% 尚有距离。Anthropic 自己也提示,前沿模型之间的榜单分差,已经不足以完整说明真实工作里的差别——在公司内部使用中,Opus 5.5 与 Fable 5.1 的差距比部分评测看上去更小。
长任务才是这次升级的重点
真正体现进步的,是持续数小时乃至十几个小时的任务。早期测试者用 Opus 5.5 在一天内做完一项涉及 68 万行代码的迁移;另一项 20 万行代码库审计耗时不到三小时,而 Opus 5 做同类任务要 20 小时以上,token 消耗约为前者的 2.5 倍。
Anthropic 还让 Opus 5.5 与 Fable 5.1 把 HAProxy 从 C 语言改写为 Rust:两者都通过了绝大多数回归测试,Opus 5.5 用了 9.5 小时,Fable 5.1 用了 12 小时,前者成本低 51%。
知识工作同样如此。在一项季度业绩报告测试里,模型只能从一份较难检索的网页副本中找资料,编造数字或引语即判失败;Opus 5.5 在不同思考强度下提交的 18 份报告中 16 份过关,Fable 5.1 与 Opus 5 一次都没达到同一标准。另一项虚构并购分析要求先在 Excel 建财务模型、再做面向管理层的演示文稿,Opus 5.5 与 Opus 5 结论一致,但前者的模型更完整、演示更清楚,耗时从 93 分钟压到 63 分钟,成本减半。
价格与速度:用户最容易感知的变化
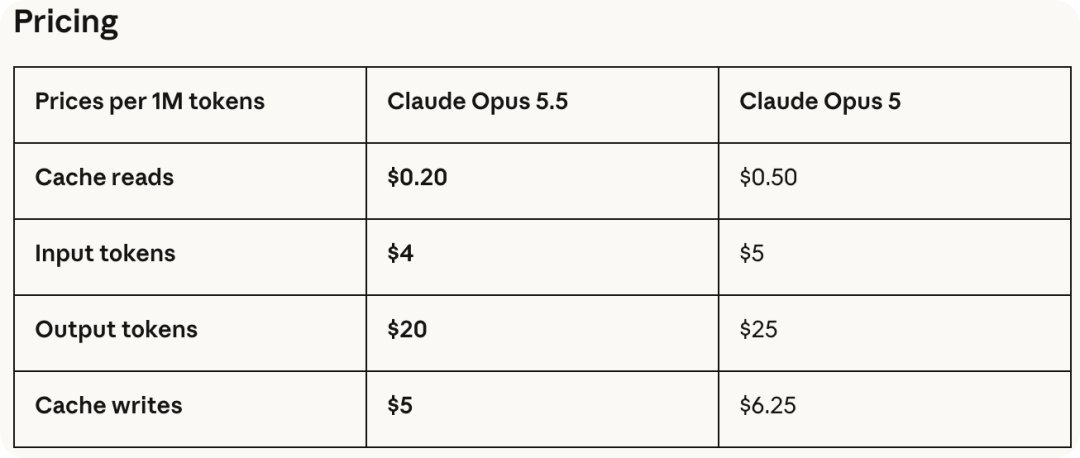
Opus 5.5 的 API 输入、输出价格分别为每百万 token 4 美元与 20 美元,比 Opus 5 低 20%;缓存读取从 0.50 美元降到 0.20 美元,降幅 60%。此外还有最高 2.5 倍速的 Fast mode,定价为每百万输入 token 8 美元、输出 token 40 美元。
模型支持 100 万 token 上下文、12.8 万 token 最大输出,思考模式常开,默认 effort 为 medium,可按任务调整强度。长时间运行的 Agent 还能借上下文压缩整理较早的对话,同时保留最近回合,减少长任务被上下文拖慢的情况。
Opus 5.5 已上线 Claude、Claude Code 和 Claude Platform,并登陆 AWS、Google Cloud 与 Microsoft Azure,API 模型名为 claude-opus-5-5,同时成为 Claude 付费计划的默认模型。
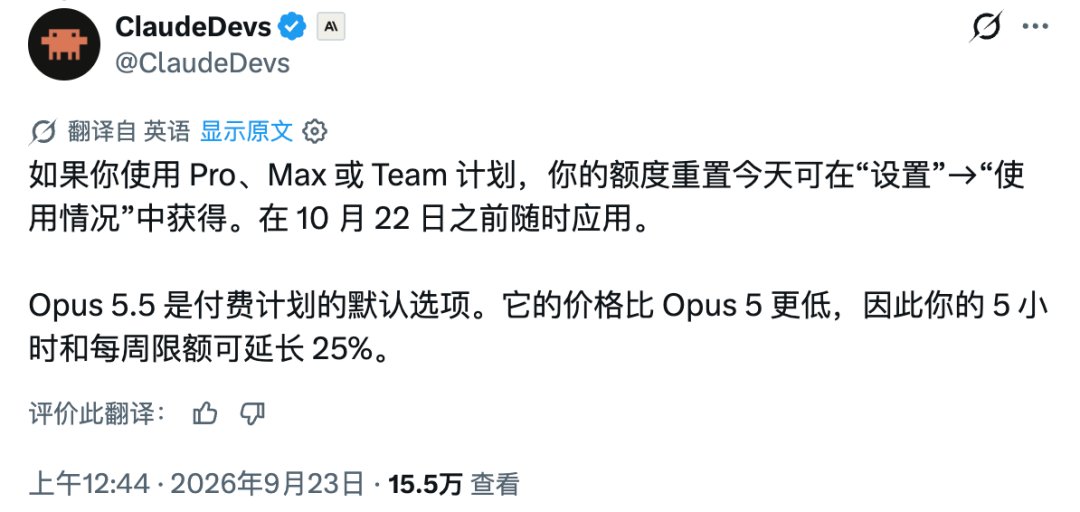
Anthropic 也上调了 Pro、Max 和 Team 计划的五小时使用限额。ClaudeDevs 称限额直接增加 20%,而更低的模型价格会让同一额度下的可用时长再增加约 25%;订阅用户另获一次可自选时间使用的额度重置,有效期至 10 月 22 日。
价格下调不等于任何设置下 token 消耗都会同步下降。有开发者依据 Artificial Analysis 的测试指出,Opus 5.5 在 max 档跑 Intelligence Index 时,输出 token 消耗是已测模型里最高的。官方所说的单任务成本下降,主要建立在默认设置与典型工作负载上,多数用户也不会长期使用 max 强度,真实成本仍受任务类型、推理档位、上下文长度和缓存命中率影响。
社区实测:创意编程亮眼,音乐创作失手
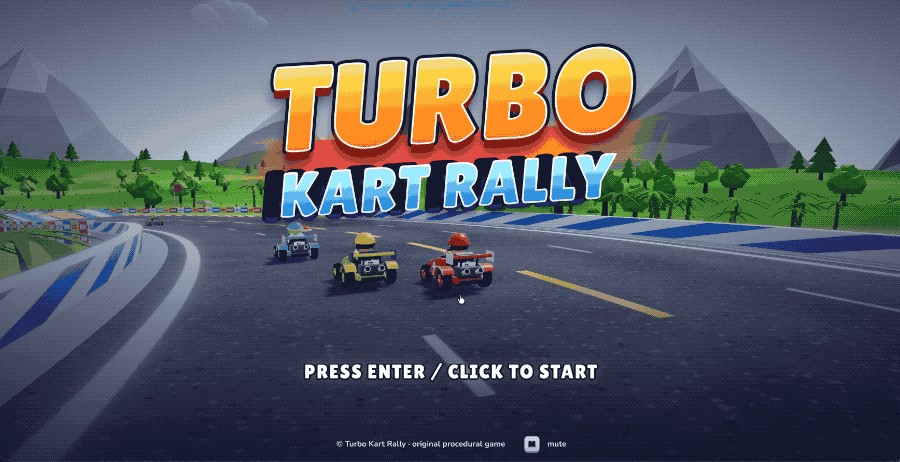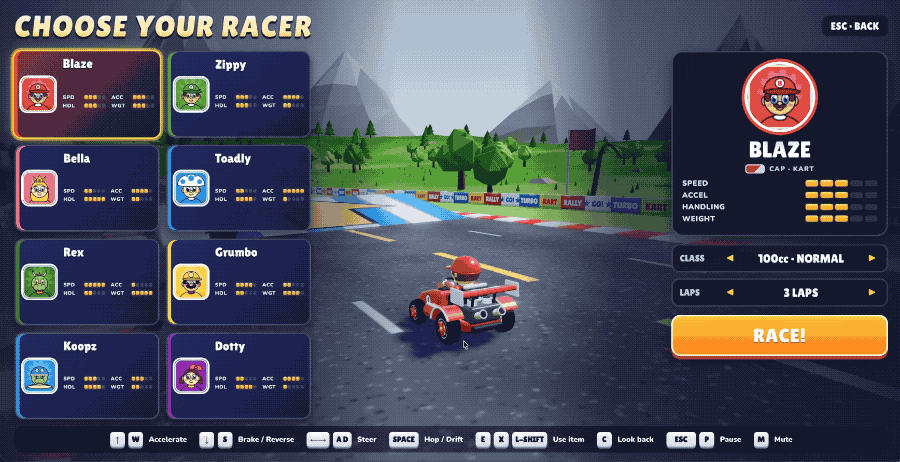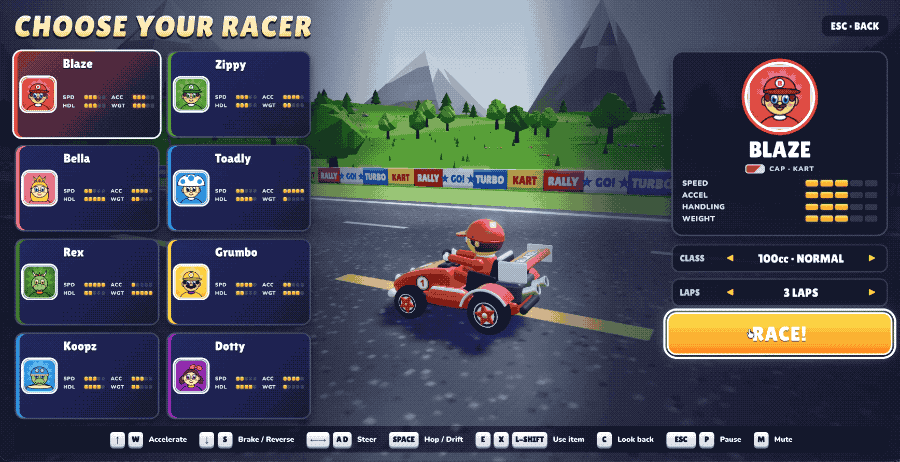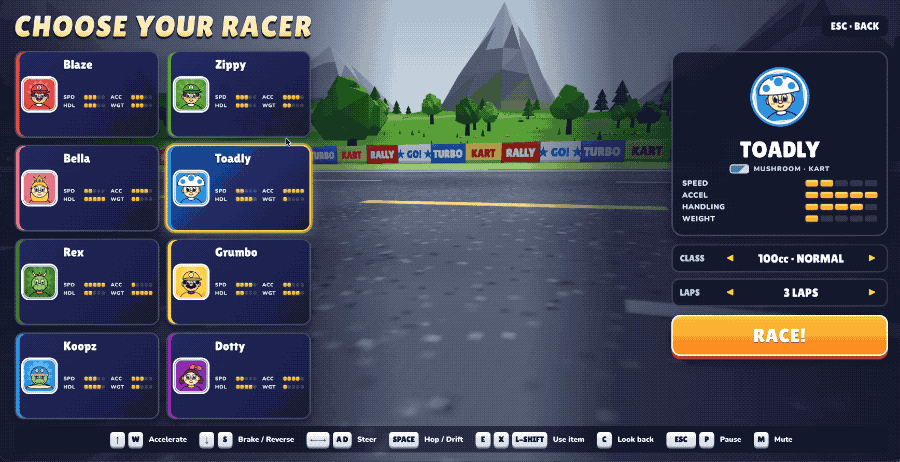
最早一批实测集中在创意编程、3D 建模和可交互模拟。Wes Bos 连续一周使用、消耗大量 token 后认为 Opus 5.5 已达到 Fable 级别;他让模型渲染了 500 种常见健身器材,并据此做出一套完整的健身房搭建器。BridgeMind 用一次提示生成了可玩的 Mario Kart 游戏,据其展示,Opus 5.5 生成的场景与玩法细节明显多于 Fable 5.1 的版本,Mario、Luigi 等角色也被做进游戏。
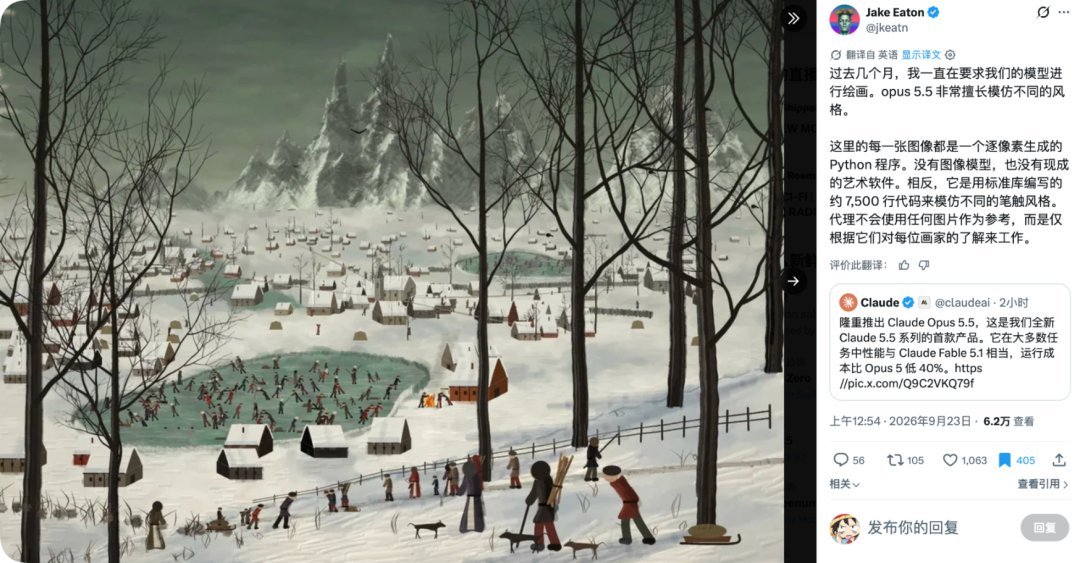
更特别的案例来自 Jake Eaton:他没有用图像模型或现成绘图软件,而是让 Opus 5.5 编写约 7500 行 Python 代码,通过标准库模拟不同笔刷,再逐像素绘制出多种艺术风格。Ben Poole 展示的 sketch-to-simulation,则让模型把草图和概念示意直接转成可运行的交互模拟。
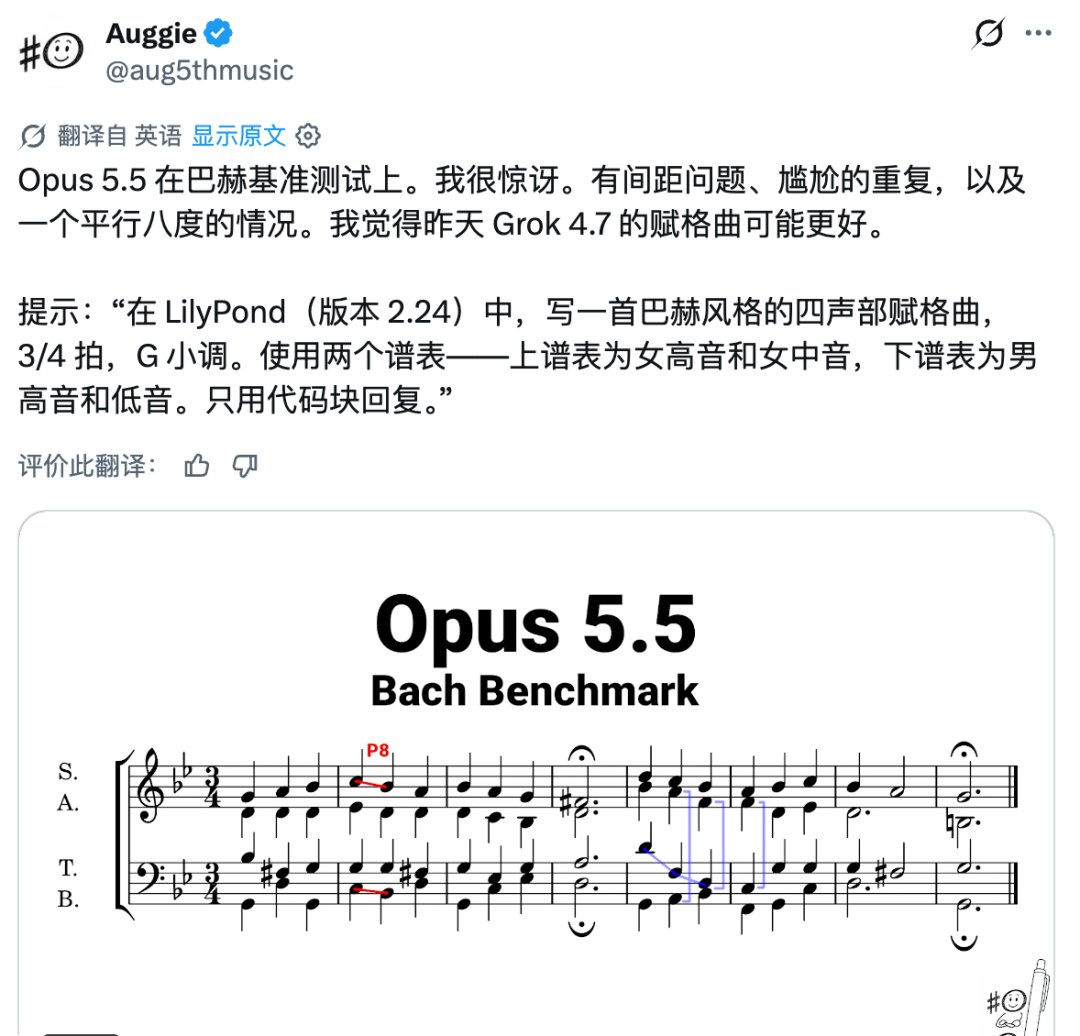
创意能力并非处处占优。Auggie 用 Bach Benchmark 测其音乐创作,生成的四声部众赞歌出现声部间距、重复音和平行八度等问题,他认为前一天 Grok 4.7 生成的版本可能更好。
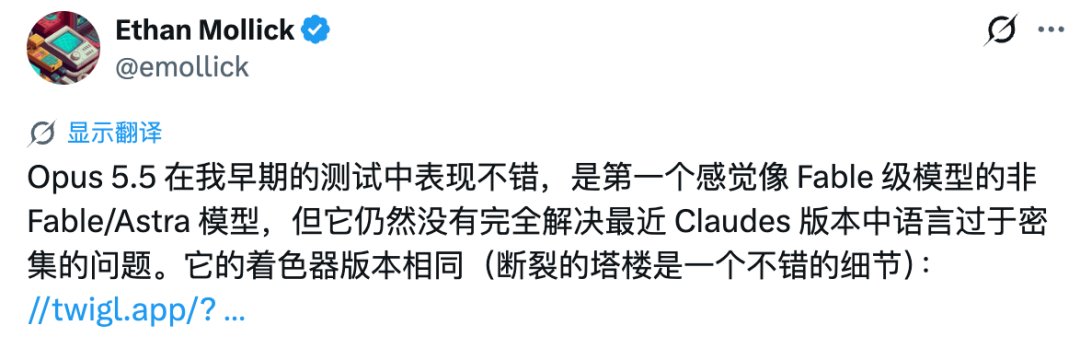
沃顿商学院教授 Ethan Mollick 在早期测试后给出更审慎的判断:Opus 5.5 是首个让他感到接近 Fable 水平、又不属于 Fable 或 Astra 系列的模型,但 Claude 近期常见的文字过密问题仍未完全消失。
Anthropic 显然注意到了这点,官方把表达能力列为本次更新重点,称 Opus 5.5 会优先给出重要信息、减少术语和特殊表达,也更愿意遵循用户设定的写作规则。对连续工作数小时的 Agent 而言,可读性不是装饰——用户能否迅速检查模型的判断,直接影响任务是否敢继续交给它。
安全:放慢竞赛节奏后的第一款模型
Opus 5.5 是 Anthropic 提出放慢前沿竞赛节奏之后发布的第一款模型。发布前,Frontier Design 和 METR 等外部机构参与了评估,Anthropic 也用覆盖近 2000 个模拟场景的自动化行为审计,检查模型的越界、欺骗与高风险行为。
官方评估显示,Opus 5.5 尝试突破限制边界的频率比 Opus 5 和 Claude Mythos 5.1 低约 85%;但 Anthropic 也承认,模型有时能察觉自己正在接受测试,现有评估仍覆盖不了真实部署中的全部风险。由于其生物与网络安全能力已接近 Mythos 5.1,Opus 5.5 启用了与 Fable 5.1 相近的安全措施:大部分网络安全任务转交 Opus 4.8,只有通过验证的安全研究人员和生命科学机构才能获得更完整的能力。它还启用了防止模型蒸馏的 preserved thinking,并保留零数据留存选项;每次操作执行前系统都会经分类器检查,企业安全团队也可审计其开源沙箱。能力越靠近前沿,权限门槛就加得越多。
从 Opus 5 到 Opus 5.5,Anthropic 只用了两个月左右。型号只前进半步,模型市场的竞争逻辑却已经变了:一个模型能否被反复调用、长时间运行,并以可接受的成本进入真实工作流,正变得比单次评测高出几个百分点更重要。旗舰能力持续降价,意味着先进智能正从稀缺服务变成可大规模使用的通用生产资料,Personal Agent 也因此拿到全天运行的经济基础——持续记住用户、理解用户,在后台处理琐事,完成过去需要人们反复发起的任务。
九月的模型发布还会制造一轮又一轮潮水,但真正改变海岸线的,从来是持续上涨的水位。
官方博客:https://www.anthropic.com/claude-opus-5-5
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。