2026 年的开源 AI 圈里,Strata 是一个很难被忽略的项目。它把行业里长期默认的一条前提推翻——千亿参数级别的模型只能依赖服务器集群——靠的是极快的迭代节奏和完全不同的技术路线。这个项目最初只是开发者个人搭起来的工具,几个月时间里就变成了本地大模型社区里的头部项目。它的工程优化目标很明确:让原本需要 8 张 H100 才能承载的 1250 亿参数模型,在一台 24G 显存的普通游戏电脑上稳定运行。所谓「人人都能在本地跑超大规模大模型」,由此不再只是一句口号。
起点:一个看上去不可能完成的任务
项目的出发点是开发者 Niko Veit 的一个判断。刚发布的 Qwen3.8-Flash-Next 总参数为 1250 亿,全精度 BF16 版本体积达到 360GB。按传统推理框架的算法,这样的模型至少得靠企业级多卡集群才勉强跑得动。
但这个模型的特殊之处在于架构:它采用 MoE 混合专家,24576 个专家中,每生成一个 token 只需要激活大约 10 个,真正参与计算的参数只占总量的 2%。
此前的主流框架基本只有两条路可走。一条是把整个模型硬塞进显存,显存需求动辄上百 GB;另一条是把闲置参数卸载到内存或固态硬盘,代价是推理速度掉到数秒才出一个 token,实际无法使用。Strata 没有沿用其中任何一条,而是换成分层存储加并行调度的组合,把消费级电脑的硬件性能尽量用满。
核心设计:把硬件当成一套分工明确的厨房
社区里流传最广的说法是「厨房调料理论」,它把整台电脑的资源拆成几个角色:
GPU 显存相当于灶台边的台面。 这里只放每轮生成都必须用到的核心组件,包括注意力模块、路由器、共享专家、输出头和一部分高频 KV 缓存;余下的显存则用来搭建自适应的专家缓存。一块 12G 显存的普通游戏显卡可以容纳 4000 多个最常用的专家。缓存还会在对话过程中持续学习:当前场景下的高频专家被换进显存,长期闲置的冷门专家被淘汰出去。整个替换在 GPU 并行计算的间隙异步完成,不会打断生成流程。
系统内存相当于家里的冰箱。 全部 24576 个专家常驻在锁定的内存空间中,以免被系统后台进程挤占而换出。一旦当前 token 需要的专家不在显存缓存里,CPU 就直接在内存中原地完成计算,与 GPU 同步工作,两边的结果最后无缝合并。传统框架里 GPU 空等数据传输的时间,因此被消除。
固态硬盘相当于储藏室。 模型附带的 28.8GB n-gram 查找表存放在 SSD 上,每生成一个 token 最多只读取 23KB 左右的数据,再配合操作系统的预取缓存,对整体速度的拖慢几乎可以忽略。
如果内存装不下全部专家,Strata 会自动切到低内存模式:显卡放不下的部分优先进入内存,剩下的专家直接从模型文件流式读取并提前预取。这样一来,32G 内存加 12G 显存的入门级游戏本也能跑起千亿级模型。
实测表现
在这套架构下,Strata 给出的成绩超出了多数人的预期:
- 一台 24G 显存的普通游戏电脑可以本地流畅运行 1250 亿参数的 Qwen3.8-Flash-Next,输出速度稳定在 60–95 tokens/s,部分优化场景下能突破百 tokens/s,已经接近云端 API 的响应水平。
- 全平台兼容:对 NVIDIA、AMD、Intel 各家显卡做了深度适配,苹果 Silicon 芯片以及 Pascal 架构的 P100/V100 等老卡同样能获得明显提升;多卡部署时负载会自动拆分,速度线性增长。
- 自带 OpenAI/Anthropic 兼容 API。本地部署完成后,原本对接云端大模型的应用基本无需改动一行代码即可切换过来,数据全程留在本机,隐私问题由此解决。
- 迭代速度是社区讨论最多的一点:作者基本保持半天一更,几乎每个新版本都能带来 10% 以上的性能提升。社区里甚至有个说法——安装包刚下载完,开发者可能已经又发了新版本。
它改变了什么
Strata 的价值并不限于「能在本地跑一个模型」。它用一个人的工程实践说明,超大规模 MoE 模型不必被服务器集群垄断,消费级硬件同样可以拥有接近云端的推理能力。
对个人开发者而言,大模型 API 的高额调用费用不再是必须承担的成本,一台普通游戏电脑就能搭起完全属于自己的本地知识库和代码助手,支持百万级超长上下文,代码与文档数据不会外泄。对中小企业而言,不必采购昂贵的 AI 服务器集群,用几台现有办公电脑就能构建可控的私有模型服务,摆脱对第三方服务商的依赖和数据泄露风险。
从实验室里的千亿级模型,到桌面上随手就能启动的日常工具,本地 AI 的门槛正在被彻底拉低。它不只是一个开源推理框架,更接近于一把钥匙。
wangyi-Strata-Qwen3.8-Flash-Next 免审核整合包
作者的实测结论是:3070 8G 显卡加 32G 内存的笔记本可以运行,但若要速度理想,显卡性能必须够强——至少 12G 显存配 64G 内存,或者 16G 显存配 48G 内存。
整合包下载
- 度盘链接:https://pan.baidu.com/s/1DDX5vJ2hrhBXSHHqT2j6UA?pwd=7eug
- 夸克网盘:https://pan.quark.cn/s/177af5525002
- 备用链接:https://pan.quark.cn/s/cfaf3c651af4
wangyi 无限画布下载
- 度盘链接:https://pan.baidu.com/s/1JMEy5Jf02uR1bCmC1yW_oQ?pwd=xqi8
- 夸克网盘:https://pan.quark.cn/s/98073c75dc52
2026 wangyi-ComfyUI-V11.8 粉丝包,免部署、解压即用。下载 models 文件夹后,移动到 2026wangyi-ComfyUI-V11.8 目录下(即有启动器的那个目录)。
模型与工作流均收集自网络,仅供个人学习研究使用;使用 AI 工具请遵守当地法律,由此产生的一切法律后果由使用者自行承担。
- 整合包下载(页面置顶位置即下载链接):https://fcnfvp8qowdj.feishu.cn/wiki/Rr4XwST66iMhtdkxv28cr5eyn2f?renamingWikiNode=true
- 1000 个「女生跳舞视频素材」夸克网盘:https://pan.quark.cn/s/0fe76baf90bf
硬件要求: 整合包约 350G,必须运行在固态硬盘上,系统必须是 Windows。生图最低 8G 英伟达显卡加 32G 内存,视频工作流同样要求至少 8G 英伟达显卡加 32G 内存,解压即用。显卡驱动务必更新到最新,老驱动达不到 CUDA 13.0 的一定会报错。
ComfyUI 模型大全
- 度盘 models:https://pan.baidu.com/s/1zN9TxUCELES2y5GhBYP7rA?pwd=s9yb
- 夸克 models:https://pan.quark.cn/s/f1bc59fb4335
本地算力不足时的在线方案
🦞MOSS SFT COMFYUI 官方工作流:https://www.runninghub.cn/ai-detail/2112738611333517313/?inviteCode=3af57631
显卡性能不足的读者可以用 runninghub 在线体验,作者的工作流都能免费在线跑。站点 www.runninghub.cn 更新较快,节点工作流保持最新,每天赠送额度,可免费生成图片和视频;LIB 的节点更新较慢,因此建议在这个站点下载工作流并免费生图、生视频,手机端同样可用。注册送 1000 点,每天登录再送 100 点——但需通过作者提供的链接注册才会赠送,否则没有新人礼。若未收到赠送,可点右上角头像,选择「邀请码」并绑定邀请码,即可获得 1000 点。
注册地址(国内用户不要点海外链接,否则访问会很慢):
- 国内:https://www.runninghub.cn/user-center/1894041412860805122/?inviteCode=3af57631
- 海外:https://www.runninghub.ai/user-center/1894041412860805122/?inviteCode=rh-v1119
其他资源与说明
runinghub 电脑、手机均可使用,开箱即用,按跑图时间计费,价格不高,每天送 100 点可免费生图生视频:https://www.runninghub.cn/user-center/1894041412860805122?inviteCode=3af57631,邀请码 3af57631(不填邀请码直接注册的不赠送点数)。
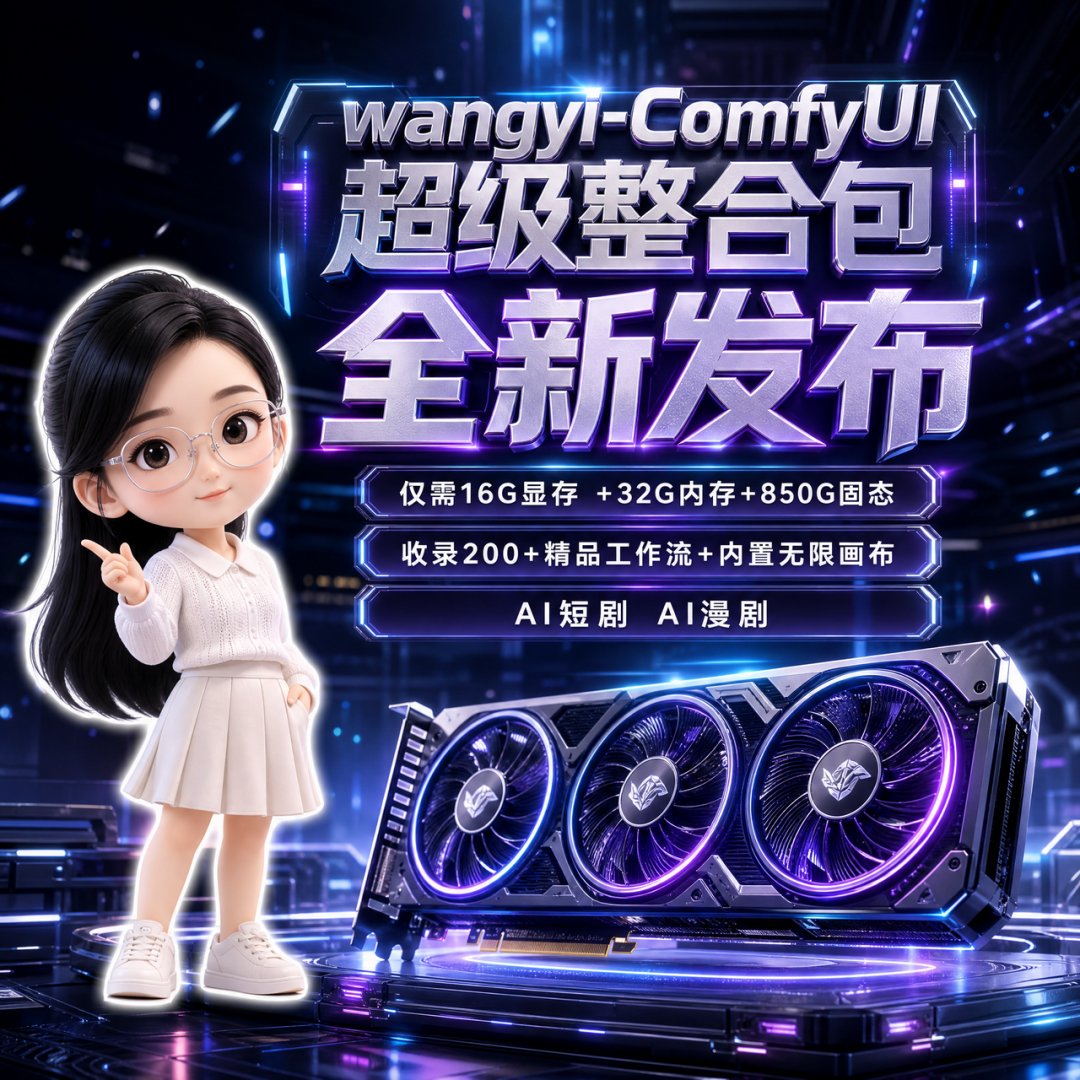
30–50 系 ComfyUI 超级整合包基于官方便携版制作,不是秋叶版也不是官方桌面版,内置 xformers、SageAttention、EasyCache 多重加速技术,视频生成时间最多减少 70%;内置大量节点、大模型与 LORA,配合附赠的精品工作流,不必担心节点缺失或运行出错。会部署环境的,自行安装作者提供的环境并指定好系统变量,解压即用;不会部署的,可另行购买远程服务,目前有优惠活动。
整合包内置约 200 个精品工作流,覆盖 MINIMAX H3、LTX2.3、FLux2 klein、Qwen3 TTS、Animate、Wan2.2、Qwen-image、flux kontext、numchaku1.2.0,以及文生图、图生图、人物脸部一致性、万物迁移、一键精修、电子小说、高清扩图、局部重绘、人物跳舞、动作迁移、人物替换、视频数字人、图片数字人、视频转绘、语音克隆等。发布前所有工作流均经过反复测试,只要环境部署到位,不会出现节点缺失和运行报错。
特别注意: 要跑通全部工作流,显卡最低 16G N 卡加 64G 内存;经作者优化后,12G 显存加 64G 内存已能跑通大部分工作流,但不是全部——配置不够时部分工作流跑不通属正常情况。爆显存会让视频生成速度极慢、显示需要数小时;爆内存则会让 ComfyUI 直接断连。为照顾低配电脑,另制作了 12G 显存加 32G 内存即可运行的视频工作流。
ComfyUI 超级整合包约 30G,模型超过 700G,因此需准备 850G 固态硬盘空间;机械硬盘速度太慢,不可使用。购买地址:https://item.taobao.com/item.htm?ft=t&id=878179571732
作者给出的理由有三条:
- 网上很多包是搬运而来,发布者自己并未跑过,下载后问题与报错不断,根本无法运行;
- 不少「大全包」「满血包」体积达好几个 T,先不说硬盘够不够,下载半天之后真正会用的模型和工作流又有多少?节点一多,问题与报错同样会多,时间、空间与精力都白白浪费;
- 还有发布者以免费分享为名放出整合包,下载后却发现有密码、缺环境、报错不断,若按包里的联系方式找他远程安装,后续的收费套路便从此开始。
想玩免费的也有作者为粉丝制作的 ComfyUI 整合包,但时效性无法保证,只用于给粉丝体验;超级 ComfyUI 整合包则会把当下最新、最好玩的节点与模型做成工作流并定时更新,测试效果不好的工作流不会收录。
 |
 |
|---|---|
本公众号提供的下载资源均来自互联网开源项目,不代表本公众号立场。如内容侵犯原著者合法权益,可联系我们处理。获取资源后仅可用于个人学习研究,不得从事违法犯罪活动,由此产生的一切法律后果需自行承担,与本公众号无关;同时拒绝任何人以任何形式在本公众号发表与中华人民共和国法律相抵触的言论。
评论 共 0 条
正在加载…
还没有评论,来说两句吧。
先起个昵称
昵称只保存在你自己的浏览器里,用来显示你的评论与留言,不需要注册。
昵称需要 2 - 20 个字符。